

Yeni bir yazılım projesinde en erken verilen ve sonradan değiştirilmesi en pahalı kararlardan biri, verinin nerede ve hangi biçimde saklanacağıdır. Veritabanı nasıl seçilir? sorusunun kısa cevabı şudur: ürün adına ya da modaya göre değil, uygulamanın soracağı sorgulara, kayıtlar arasındaki ilişkilere ve tutarlılık ihtiyacına göre. Yanlış seçim ilk haftalarda belli olmaz; veri büyüdüğünde ve raporlar çoğaldığında yavaşlık ya da tutarsızlık olarak geri döner.
Bu rehberde veritabanı türlerini, sorguları önce yazma yöntemini, veri modeli kararını, tutarlılığın iş dilindeki karşılığını, indeksin etkisini sayılarla, altı soruluk karar testini, barındırma ve yedekleme noktalarını, geçiş riskini ve sık hataları anlatıyoruz. Örnek rakamlar temsilîdir; belirli bir ürünün ölçümü ya da sektör ortalaması değildir ve ürün adı verilmez.
Veritabanı Türleri Nelerdir ve Hangisi Ne Zaman Uygundur?
Beş ana aile vardır: ilişkisel, belge, anahtar-değer, arama ve zaman serisi ya da analitik. Her biri farklı bir sorguya göre en iyi çalışır; bu yüzden "en iyi" yoktur, "bu işe uygun olan" vardır.
| Tür | Veriyi nasıl tutar? | Ne zaman uygundur? | Dikkat edilecek nokta |
|---|---|---|---|
| İlişkisel | Tablolar, satırlar, tablolar arası bağlar | Sipariş, stok, cari hesap, fatura; çok alanlı filtre ve rapor | Şema önceden tasarlanır; çok büyük yazma hacminde ölçekleme planı gerekir |
| Belge | Her kayıt kendi içinde iç içe bir belge | Şeması değişken, kayıtlar genelde bütün olarak okunan veri: katalog özellikleri, içerik | Kayıtlar arası bağ ve çok kayıtlı işlem zayıf kalabilir; veri tekrarı artar |
| Anahtar-değer | Bir anahtara karşılık bir değer | Oturum, önbellek, sayaç, geçici veri; anahtarla çok hızlı okuma | Anahtar dışında sorgu yok denecek kadar sınırlı |
| Arama | Metni ters indeksle tutar | Tam metin arama, yazım toleransı, çok alanlı filtre ve sıralama | Asıl kayıt yeri olmamalı; ana veriden yeniden üretilebilir kopya olarak kullanılır |
| Zaman serisi / analitik | Zamana göre sıralı ya da sütun bazlı | Sensör ölçümü, günlük kaydı, büyük toplu raporlar | Tek tek kayıt güncellemeye uygun değildir |
İş yazılımlarının büyük çoğunluğunda asıl kayıt yeri ilişkisel bir veritabanıdır; diğer türler genellikle ona eşlik eden yardımcı depolardır. Mimariyi parçalara bölmenin getirdiği ek yükü mikroservis mimarisi rehberimizde ayrıca ele aldık.
Okumanızı öneririz: Özel yazılım hizmetimiz
Önce Sorguları Yazmak Ne Demektir?
Önce sorguları yazmak, veritabanını seçmeden önce uygulamanın en sık ve en kritik 10 sorusunu, sıklıklarıyla birlikte listelemektir. Seçim bu listeden çıkar.
Örnek olarak müşteri portalı rehberimizdeki bayi portalını alalım. Aşağıdaki liste temsilîdir.
| Sorgu | Günlük sıklık | Gereksinim | Uygun yapı |
|---|---|---|---|
| Bayinin son 30 günlük siparişleri | 60.000 | İlişkili kayıt, tarih filtresi | İlişkisel |
| Sipariş oluştur ve stoktan düş | 8.000 | İki kayıt birlikte değişmeli | İlişkisel, işlem desteği |
| Oturum anahtarını doğrula | 100.000 | Çok hızlı, geçici veri | Anahtar-değer |
| Ürün adında serbest metin arama | 25.000 | Yazım toleransı, sıralama | Arama |
| Aylık satış toplamları | 7.000 | Büyük toplulaştırma | İlişkisel ya da analitik kopya |
Toplam 200.000 istek ÷ 86.400 saniye ≈ 2,3 istek/sn ortalamadır. Gün içinde yığılma için tepe çarpanını 10 alırsak ≈ 23 istek/sn eder. Bu seviye tek bir ilişkisel sunucunun rahat taşıdığı bir yüktür; yani örnekte "ölçek" gerekçesiyle farklı bir veritabanına geçmeye gerek yoktur. Gereksinimin yazılı hale gelmesi için gereksinim analizi rehberimizdeki sorgu ve kabul kriteri mantığı işe yarar.
Veri Modeli Kararı Nasıl Verilir?
Üç soru modeli belirler: kayıtlar arasında ilişki var mı, hangi işlemler bütün olarak başarılı ya da başarısız olmalı, şema ne kadar değişken?
- İlişkiler: Müşteri, sipariş, sipariş satırı ve ürün birbirine bağlıysa ve bu bağlar üzerinden sorgu yapılıyorsa ilişkisel model doğal karşılıktır. Kayıt kendi içinde tamamsa (ürünün tüm özellik listesi gibi) belge modeli işe yarar.
- Tutarlılık: Para, stok ve fatura gibi alanlarda yanlış sayı doğrudan zarardır. Burada işlem desteği pazarlık konusu değildir.
- Şema esnekliği: Kayıtların yarısı farklı alanlar taşıyorsa belge modeli kolaylık sağlar. Alanların %80'i ortaksa şemayı önceden tanımlamak hatayı erken yakalar.
Esneklik, bedelsiz değildir: şemanın veritabanında değil kodda tutulduğu yerde her okuyan kod her varyantı bilmek zorunda kalır.
Tutarlılık (ACID) İş Dilinde Ne Anlama Gelir?
ACID, bir işlemin ya tamamen gerçekleşmesi ya da hiç gerçekleşmemesidir. Nihai tutarlılık ise güncellemenin kopyalara bir süre sonra yayılmasıdır. Hangisinin gerektiği, işin yanlış sayıya ne kadar tahammül ettiğine bağlıdır.
Örnek: stokta 5 adet ürün var ve iki bayi aynı anda 4'er adet sipariş veriyor. İşlem desteği ve kilit yoksa iki kontrol de "5 ≥ 4" görür, iki sipariş de kabul edilir ve stok 5 − 4 − 4 = −3 olur. İşlemli yapıda ikinci sipariş birincinin sonucunu görür (kalan 1 < 4) ve reddedilir.
| Konu | ACID (güçlü tutarlılık) | Nihai tutarlılık |
|---|---|---|
| Garanti | İşlem bütün olarak uygulanır ya da geri alınır | Kopyalar kısa süre farklı olabilir |
| Uygun alan | Sipariş, stok düşümü, ödeme, fatura | Ürün görüntülenme sayısı, öneri listesi, katalog görünümü |
| Yanlışın bedeli | Eksi stok, çift ödeme | Birkaç saniye eski sayı |
| Yazma hızı | Kilit ve doğrulama maliyeti vardır | Daha yüksek ve yaygın ölçeklenir |
Pratik kural: bir sayının yanlış görünmesi yalnızca can sıkıyorsa nihai tutarlılık yeter; yanlış işlem para ya da stok kaybettiriyorsa işlem desteği şarttır. Aynı uygulamada ikisi birlikte bulunabilir: sipariş ilişkisel veritabanında kesinleşir, vitrin sayfası gecikmeli bir kopyadan okunur.
İndeks Sorgu Süresini Nasıl Etkiler?
İndeks, veritabanının tabloyu baştan sona okumadan aradığı kaydı bulmasını sağlayan ek bir yapıdır. Kitap dizini gibi çalışır; doğru kurulduğunda sorgu süresini yüzlerce kat kısaltır.
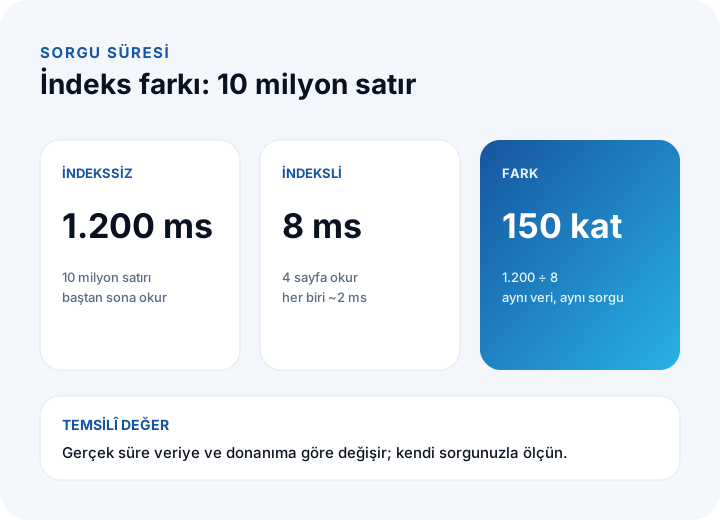
Temsilî örnek: 10.000.000 satırlık sipariş tablosunda bir bayinin siparişlerini arıyoruz. İndeks yoksa veritabanı 10 milyon satırın hepsini okur; süre 1.200 ms olsun. İndeks varsa, dallanma sayısı yüksek bir ağaç yapısında kayıt birkaç sayfa okumayla bulunur: yaklaşık 4 sayfa × 2 ms = 8 ms. Fark 1.200 ÷ 8 = 150 kat.
İndeksin bedeli de vardır. Tablo her satır için 200 bayt tutarsa 10.000.000 × 200 = 2.000.000.000 bayt ≈ 2 GB eder; satır başına 24 baytlık bir indeks 10.000.000 × 24 = 240 MB ek alan ister. Üstelik her yazma, tabloyla birlikte indeksleri de günceller: 5 indeks varsa tek kayıt eklemek 1 + 5 = 6 yazma demektir.
| Durum | İndeks kararı |
|---|---|
| Sık filtrelenen ya da birleştirilen alan (bayi no, tarih) | İndeks ekleyin |
| Çok az farklı değer taşıyan alan (aktif/pasif) | Tek başına genelde yarar sağlamaz |
| Çok yazılan, az sorgulanan tablo | İndeksi asgaride tutun |
| Yavaşlık şikâyeti | Önce sorgu planına bakın, sonra indeks ekleyin |
Dolayısıyla "yavaş, o halde başka veritabanı" refleksi çoğu zaman yanlıştır: 10 milyon satır modern bir sunucu için küçük bir tablodur ve eksik indeks, veritabanı türünü değiştirmeden çözülebilen en yaygın yavaşlık nedenidir.
Altı Soruluk Veritabanı Seçim Testi
Aşağıdaki soruları uygulamanın ana verisi için yanıtlayın. Her "evet" ilişkisel veritabanı lehine bir puandır.
- Kayıtlar arasında ilişki var ve bu bağlar üzerinden sorgu yapılıyor mu?
- Birden çok kaydın birlikte değiştiği ve yarım kalmaması gereken işlemler (sipariş, ödeme, stok) var mı?
- Önceden bilmediğiniz alan kombinasyonlarıyla filtre ve rapor ihtiyacı doğacak mı?
- Kayıtların çoğu aynı alanları taşıyor, yani şema önceden tanımlanabilir mi?
- Ekibiniz sorgu dilini biliyor ve bu beceri piyasada bulunabilir mi?
- Yük, tek sunucunun karşılayabileceği düzeyde mi (örnekteki gibi ≈ 23 istek/sn tepe)?
| "Evet" sayısı | Anlamı | Önerilen adım |
|---|---|---|
| 5–6 | İlişkisel güçlü aday | Asıl kayıt yeri olarak ilişkisel seçin, indeks planını yazın |
| 3–4 | İlişkisel temel, bir özel ihtiyaç var | İlişkisel + o ihtiyaç için yardımcı depo (arama ya da önbellek) |
| 0–2 | Karışık ya da özel yük | Sorgu listesini çıkarın, adayları gerçek veriyle sınayın |
Test bir karar değil, bir başlangıç noktasıdır; kararı gerçek veriyle ölçmek gerekir. Seçimin maliyetini kalemlere ayırmak için yazılım projesi maliyeti rehberimize bakabilirsiniz.
Çoğu İş Uygulaması Neden İlişkisel Veritabanıyla Başlar?
Çünkü iş verisi doğası gereği ilişkilidir: müşteri sipariş verir, sipariş satırlardan oluşur, satır bir ürüne bağlanır, fatura siparişe bağlanır. Bu bağları veritabanı katmanında tutmak hem hatayı azaltır hem de rapor sorgularını kolaylaştırır.
- Olgun ve bilinen: Sorgu dili yaygındır; ekip bulmak ve devretmek kolaydır.
- Raporlama: Önceden planlanmamış bir rapor ihtiyacı çıktığında aynı veri üzerinde yeni sorgu yazılır.
- Bütünlük kuralları: Olmayan müşteriye sipariş yazılması gibi hatalar veritabanı seviyesinde engellenir.
- Esneklik payı: Birçok ilişkisel veritabanı yapısal olmayan alanları da belge benzeri biçimde tutabilir; küçük esneklik ihtiyacı için ayrı bir tür gerekmez.
Yardımcı depolar ihtiyaç doğdukça eklenir ve tek bir kural geçerlidir: gerçeğin tek kaynağı olan bir asıl kayıt yeri bulunur; arama dizini ve önbellek ondan yeniden üretilebilir kopyalardır. Bu kural, kopyalar bozulduğunda sistemi baştan kurmadan yeniden üretme imkânı verir. Sistemler arası veri akışı için API entegrasyonu rehberimiz yol gösterir.
Barındırma, Yedekleme ve KVKK Açısından Nelere Bakılmalı?
Seçim yalnızca teknik değildir; verinin nerede durduğu, kim tarafından işletildiği ve nasıl geri getirileceği de karardır.
- Yönetilen hizmet ya da kendi sunucunuz: Yönetilen hizmet bakım yükünü azaltır, ama veri konumu ve maliyet sözleşmeye bağlıdır. Kendi sunucunuzda kontrol sizdedir, işletme yükü de sizdedir.
- Veri konumu ve erişim: Kişisel veri içeren kayıtların nerede tutulduğu, kimin eriştiği ve şifreleme KVKK kapsamında değerlendirilir; hukuki ayrıntılar için hukuk danışmanınıza başvurun.
- Yedekleme ve geri yükleme: Seçilen türün yedekleme yöntemi, hedeflenen RPO ve RTO ile uyumlu mu? Bu kavramları veri yedekleme rehberimizde adım adım anlattık.
- Yetki ve denetim: Rol bazlı erişim, değişikliklerin kaydı ve ortam ayrımı (deneme ve gerçek) baştan planlanır. API üzerinden erişimde API güvenliği rehberimizdeki katmanlar geçerlidir.
Veritabanı Değiştirmenin Riski ve Maliyeti Nedir?
Veritabanı değiştirmek yalnızca veriyi taşımak değildir; sorgular, iş kuralları ve raporlar da yeniden yazılır. Bu yüzden yanlış seçimin bedeli geç ödenir.
Temsilî örnek: 60 kişi-günlük bir sistemin veri erişim katmanı ve sorgularının %25'i yeniden yazılacaksa 60 × 0,25 = 15 kişi-gün eder; günlük ₺9.000 ile 15 × ₺9.000 = ₺135.000. Buna veri doğrulama, paralel çalıştırma ve olası kesinti eklenir.
- Veri erişimini tek katmanda toplayın: Sorgular uygulamanın her yerine dağılmışsa geçiş maliyeti katlanır.
- Taşıma doğrulaması yapın: Kaynak ve hedefte kayıt sayısı, toplamlar ve örnek kayıtlar karşılaştırılır.
- Paralel çalışma: Yeni yapı bir süre eski yapıyla birlikte çalışır; fark çıkmayınca geçilir.
Veritabanı Seçerken Hangi Altı Adım İzlenir?
Seçimi bir tartışmadan çıkarıp ölçülebilir bir sürece dönüştürmek için altı adım yeterlidir.
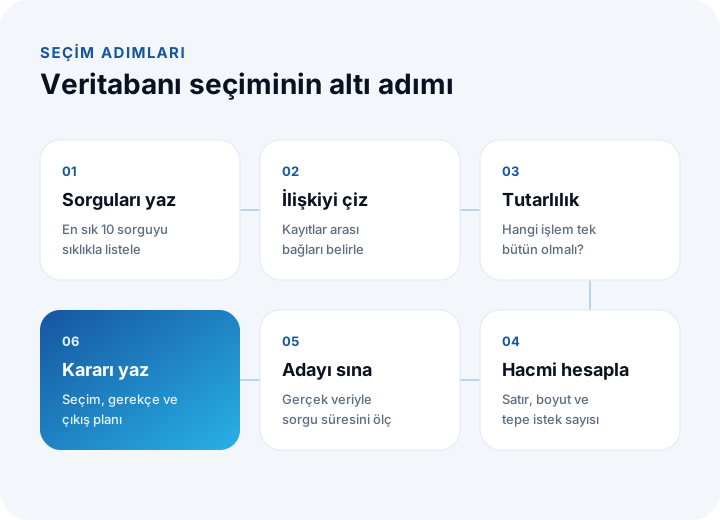
- Sorguları yazın: En sık ve en kritik 10 sorguyu, günlük sıklıklarıyla listeleyin.
- İlişkiyi çizin: Kayıtlar arası bağları ve hangilerinin birlikte sorgulandığını belirleyin.
- Tutarlılığı belirleyin: Hangi işlemlerin bütün olarak başarılı ya da başarısız olması gerektiğini işaretleyin.
- Hacmi hesaplayın: Satır sayısı, kayıt boyutu ve tepe istek sayısını yazın (200.000 ÷ 86.400 × 10 ≈ 23).
- Adayı sınayın: Gerçeğe yakın veriyle, kritik sorguların süresini ve yük altındaki davranışı ölçün.
- Kararı yazın: Seçimi, gerekçeyi, indeks planını, yedekleme hedefini ve çıkış planını belgeleyin.
Veritabanı Seçiminde Sık Yapılan Hatalar Nelerdir?
- Modaya göre seçmek: Başka bir şirkette işe yarayan seçim, sizin sorgularınız için uygun olmayabilir.
- Ölçeği abartmak: Günde milyonlarca istek beklemeden dağıtık yapıya geçmek karmaşıklığı büyütür. 23 istek/sn tepe, tek sunucunun işidir.
- İndeksi atlamak: Yavaşlığı veritabanının suçuna yazıp sorgu planına bakmamak.
- Para ve stoku tutarsız depoda tutmak: İşlem desteği olmayan yerde eksi stok ve çift kayıt kaçınılmazdır.
- Her ihtiyaç için ayrı veritabanı eklemek: Her yeni depo bir yedekleme, izleme ve güvenlik işi daha demektir.
- Çıkış planı olmamak: Verinin dışarı alınabildiği sınanmadan seçim yapılır.
Okumanızı öneririz: Özel yazılım nedir? Türler, katmanlar ve karar rehberi
İnovabil ile Özel Yazılım ve Veri Mimarisi
İnovabil olarak ağırlığımız sıfırdan, firmaya özel yazılım geliştirmektir: özel yazılım, ERP, CRM, e-ticaret, web, mobil ve entegrasyon. Veri yapısı kararını gereksinim analizinde, sorgu listesi, tutarlılık ihtiyacı ve yedekleme hedefiyle birlikte yazılı hale getirmeyi öneriyoruz; böylece seçim sonradan tartışma konusu olmaz.
Avcılar İnşaat için CRM, satın alma ve mobil; İZBAN için satın alma sistemi; Karyak için lojistik ve sevkiyat planlama ile toptan sipariş yönetimi; Sleepy için depo yönetimi ile şikâyet ve destek yönetim sistemi geliştirdik. Mevcut sisteminiz ve beklenen kullanım hakkında kısa bir özet gönderin; sorgu listesini ve veri modelini birlikte çıkaralım.
Okumanızı öneririz: Yazılım geliştirme sürecimiz: analizden yayına adım adım
Sık Sorulan Sorular
Veritabanı nasıl seçilir, kısaca hangi kriterlere bakılır?
Uygulamanın sorgularına, kayıtlar arasındaki ilişkilere, tutarlılık ihtiyacına, şema esnekliğine ve beklenen yüke bakılır. Önce en sık 10 sorguyu ve hacmi yazın; seçimi bu listeye göre yapın, ürün popülerliğine göre değil.
İlişkisel veritabanı ile belge veritabanı arasındaki fark nedir?
İlişkisel veritabanı veriyi tablolar ve aralarındaki bağlarla tutar; çok kayıtlı işlem ve esnek sorguda güçlüdür. Belge veritabanı her kaydı iç içe bir belge olarak tutar; şeması değişken ve bütün olarak okunan veride kolaydır.
Her yeni projede ilişkisel veritabanı mı seçilmeli?
Çoğu iş uygulamasında başlangıç için mantıklıdır; çünkü iş verisi ilişkili ve para ya da stok işlemleri tutarlılık ister. Altı soruluk testte 5–6 evet çıkıyorsa güçlü adaydır; özel bir yük varsa yardımcı bir depo eklenir.
Sorgular yavaşsa veritabanını değiştirmek gerekir mi?
Çoğu zaman hayır. Örnekte 10 milyon satırlık tabloda indeksle süre 1.200 ms'den 8 ms'ye iner (150 kat). Önce sorgu planına ve eksik indekse bakın; tür değiştirmek son çare olmalıdır.
Veritabanı seçimi KVKK ve yedekleme açısından neyi etkiler?
Verinin tutulduğu yer, erişim yetkileri, şifreleme ve yedek yöntemi seçime bağlıdır. Hedef RPO ve RTO'yu baştan yazın; hukuki ayrıntılar için hukuk danışmanınıza başvurun.